Когда приложение работает стабильно, пользователи редко думают о том, сколько систем стоит за привычной кнопкой, формой заявки или личным кабинетом. Но для команды эксплуатации каждое действие превращается в цепочку событий: веб-сервер принимает запрос, API обращается к базе, очередь передает задачу дальше, внешний сервис возвращает ответ, а интерфейс показывает результат. Если в этой цепочке появляется задержка, ошибку важно увидеть не тогда, когда жалобы уже пришли в поддержку, а в момент первых признаков деградации. Поэтому бизнесу нужно российское решение для мониторинга приложений, которое помогает смотреть на сервис целиком и быстро понимать, где именно возникла проблема.
Современный мониторинг приложений отличается от простой проверки доступности сайта. Недостаточно знать, что страница открывается с кодом 200. Сервис может формально отвечать, но медленно считать корзину, терять часть транзакций, ошибаться при оплате или зависать на интеграции с партнерской системой. Для пользователя это выглядит как «сайт не работает», а для инженера без нормальной наблюдаемости превращается в долгий поиск по логам и разрозненным панелям.
Что именно нужно видеть в приложении
У приложения есть несколько уровней здоровья. Первый уровень — доступность: отвечает ли сервис, проходит ли базовый сценарий, не закончился ли сертификат, не упал ли балансировщик. Второй уровень — производительность: сколько времени занимает ответ, как меняется latency в пиковые часы, какие эндпоинты тормозят чаще всего. Третий уровень — корректность бизнес-операций: проходят ли заказы, создаются ли документы, отправляются ли уведомления, не растет ли очередь необработанных задач.
Если наблюдать только один уровень, картина будет неполной. Например, инфраструктура может выглядеть здоровой, а пользователи все равно сталкиваются с ошибками в конкретном сценарии. Или наоборот: сервер перегружен, но бизнес-процесс пока не пострадал, и у команды есть время спокойно увеличить ресурсы. Хорошая система мониторинга связывает технические метрики с прикладной логикой и помогает отличать критический инцидент от обычного всплеска нагрузки.
Почему разрозненных дашбордов уже недостаточно
Во многих компаниях исторически складывается набор отдельных инструментов: один показывает серверы, второй собирает логи, третий следит за сетью, четвертый проверяет сайт снаружи. Пока сервисов мало, такая схема кажется рабочей. Но с ростом числа приложений и интеграций инженеры начинают терять время на переключение между окнами. А в аварийной ситуации важны минуты: нужно быстро понять, где причина, кого подключать и что можно сделать прямо сейчас.
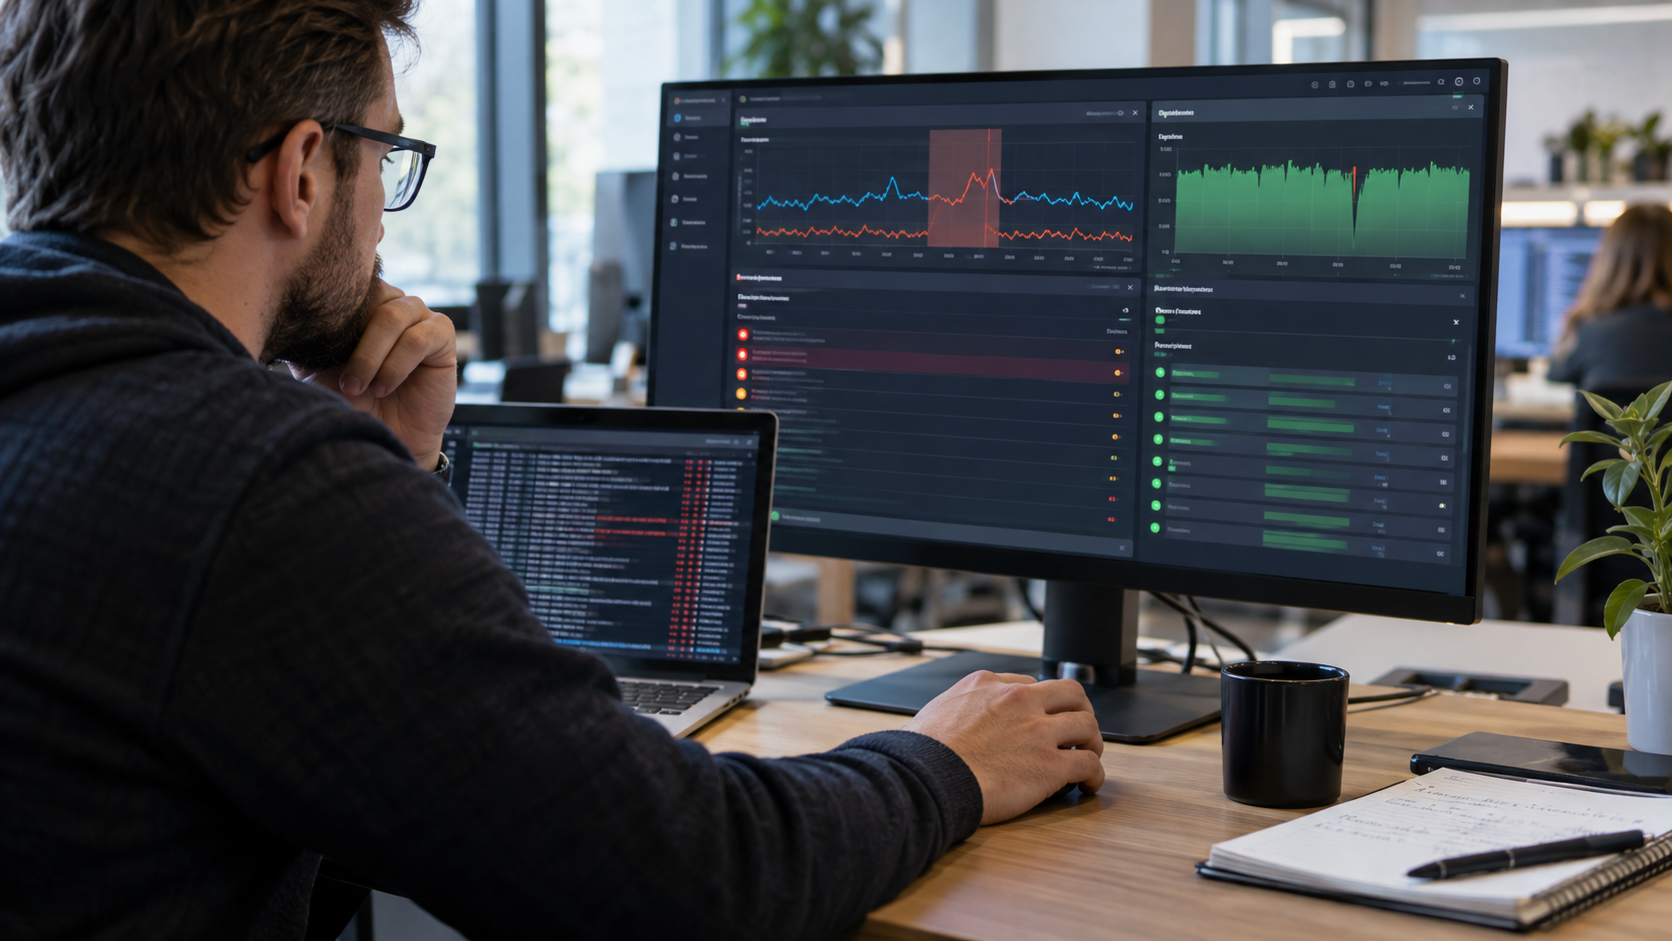
Единая платформа наблюдаемости снижает этот шум. Она собирает события, метрики, доступность и прикладные проверки в одну рабочую картину. Команда видит не только красный индикатор, но и контекст: какой компонент затронут, какие зависимости могли повлиять на сбой, когда началось отклонение, какие пользователи или филиалы почувствовали проблему. Это особенно важно для распределенных систем, где один инцидент может проявляться сразу в нескольких местах.
Как мониторинг помогает предупреждать сбои
Главная ценность мониторинга не в красивых графиках, а в раннем обнаружении отклонений. Если время ответа платежного модуля постепенно растет, база данных начинает отвечать медленнее, а количество ошибок на одном API увеличивается, система должна показать это до массового отказа. Тогда команда успевает проверить релиз, откатить изменение, перераспределить нагрузку или заранее предупредить бизнес-подразделение.
Для этого важны не только пороги, но и динамика. Жесткое правило «ошибка выше 5%» полезно, но оно не всегда учитывает сезонность и реальные паттерны нагрузки. Более зрелый подход строится на сравнении с нормальным поведением сервиса: что обычно происходит утром, как выглядит пик продаж, сколько времени занимает типовая операция. Чем точнее система понимает норму, тем меньше ложных тревог и тем быстрее замечаются настоящие проблемы.
Роль синтетических проверок и пользовательских сценариев
Одна из практичных техник — синтетический мониторинг. Система регулярно выполняет важные пользовательские сценарии: открывает каталог, авторизуется, добавляет товар, проверяет форму заявки, обращается к API или проходит другой путь, критичный для бизнеса. Такой подход показывает не абстрактную доступность сервера, а фактическую работоспособность сценария.
Синтетические проверки особенно полезны ночью, в выходные и после релизов. Если обновление нарушило один из ключевых сценариев, дежурная команда получает сигнал сразу. При этом проверка должна быть настроена аккуратно: не создавать реальные платные операции, не засорять базу тестовыми заказами и не обходить защитные механизмы. Хорошая практика — выделять безопасные тестовые маршруты и заранее согласовывать их с владельцами продукта.
Логи, метрики и трассировка в одной цепочке
Когда инцидент уже произошел, команде нужно быстро перейти от симптома к причине. Метрики показывают, что выросла задержка. Логи объясняют, какие ошибки появились в этот момент. Трассировка помогает пройти путь конкретного запроса через несколько сервисов и увидеть, на каком участке он задержался. По отдельности эти данные полезны, но настоящий эффект появляется, когда они связаны между собой.
Например, алерт сообщает о росте ошибок в мобильном API. Инженер открывает карточку события и сразу видит связанные запросы, проблемный метод, всплеск таймаутов к внешнему сервису и последние изменения в релизе. Вместо ручного поиска по нескольким системам он получает гипотезу за минуты. Это сокращает MTTR — среднее время восстановления — и уменьшает влияние инцидента на пользователей.
Почему российская платформа важна для части компаний
Для организаций с требованиями к импортонезависимости, внутренним регламентам и хранению данных выбор инструмента мониторинга часто упирается не только в функциональность. Важны размещение, поддержка, юридическая прозрачность, понятная документация и возможность интеграции с уже используемой инфраструктурой. Российская платформа может быть удобнее там, где нужно быстрее согласовать внедрение, получить поддержку на русском языке и встроить решение в существующие процессы эксплуатации.
Отдельный плюс — адаптация к локальным условиям. Команде проще обсуждать SLA, обновления, сценарии внедрения и особенности интеграций с поставщиком, который понимает российский рынок и типовые ограничения корпоративной ИТ-среды. Это не отменяет технических требований, но делает проект внедрения более предсказуемым.
Какие признаки отличают полезный мониторинг
При выборе решения стоит смотреть не на количество экранов, а на то, помогает ли инструмент принимать решения. Полезная система быстро отвечает на несколько вопросов: что сломалось, насколько это критично, когда началось, какие сервисы затронуты, есть ли связь с релизом или изменением конфигурации, кто должен реагировать. Если для ответа на эти вопросы инженеру приходится вручную собирать данные из разных мест, нагрузка на команду остается высокой.
Также важна гибкость алертов. Слишком чувствительные правила превращают дежурство в поток шума, а слишком грубые правила пропускают ранние признаки проблем. Настройки должны учитывать важность сервисов, расписание, разные уровни эскалации и возможность подавлять ожидаемые события во время плановых работ. Тогда алерты воспринимаются как рабочий сигнал, а не как фон, который все постепенно начинают игнорировать.
Интеграция с процессами эксплуатации
Мониторинг не должен жить отдельно от реальной работы команды. Если инцидент найден, нужна связка с каналами уведомлений, системой заявок, базой знаний и регламентами реагирования. Дежурный должен видеть, что делать сначала, где находится инструкция, кого подключить и какие действия уже предпринимались. Для критичных сервисов полезны шаблоны постмортемов и история похожих случаев.
Такой подход превращает мониторинг из набора графиков в инструмент управления надежностью. Команда не только тушит пожары, но и видит повторяющиеся причины: нестабильные интеграции, слабые места архитектуры, нехватку ресурсов, проблемы релизного процесса. Эти данные помогают планировать технический долг и аргументировать изменения перед бизнесом.
С чего начать внедрение
Начинать лучше не со всех систем сразу, а с нескольких критичных пользовательских маршрутов. Для интернет-магазина это может быть поиск товара, корзина и оформление заказа. Для личного кабинета — авторизация, просмотр данных и отправка заявки. Для внутренней системы — создание документа, согласование и выгрузка отчета. Когда эти маршруты описаны, проще подобрать метрики, пороги и ответственных.
Затем стоит добавить инфраструктурные зависимости: базы данных, очереди, внешние API, балансировщики, сетевые точки. После этого можно связывать события между уровнями и настраивать понятные дашборды для разных ролей. Руководителю эксплуатации нужна общая картина надежности, дежурному инженеру — технические детали, владельцу продукта — влияние на бизнес-операции.
Итог
Надежность приложения складывается из множества мелких сигналов. Один график редко показывает всю проблему, но связанная система метрик, логов, трассировки и пользовательских проверок позволяет увидеть ее раньше и устранить быстрее. Для компаний, которым важны локальная поддержка, контроль данных и понятное внедрение, российское решение для мониторинга приложений становится не просто ИТ-инструментом, а частью управления качеством цифровых сервисов.